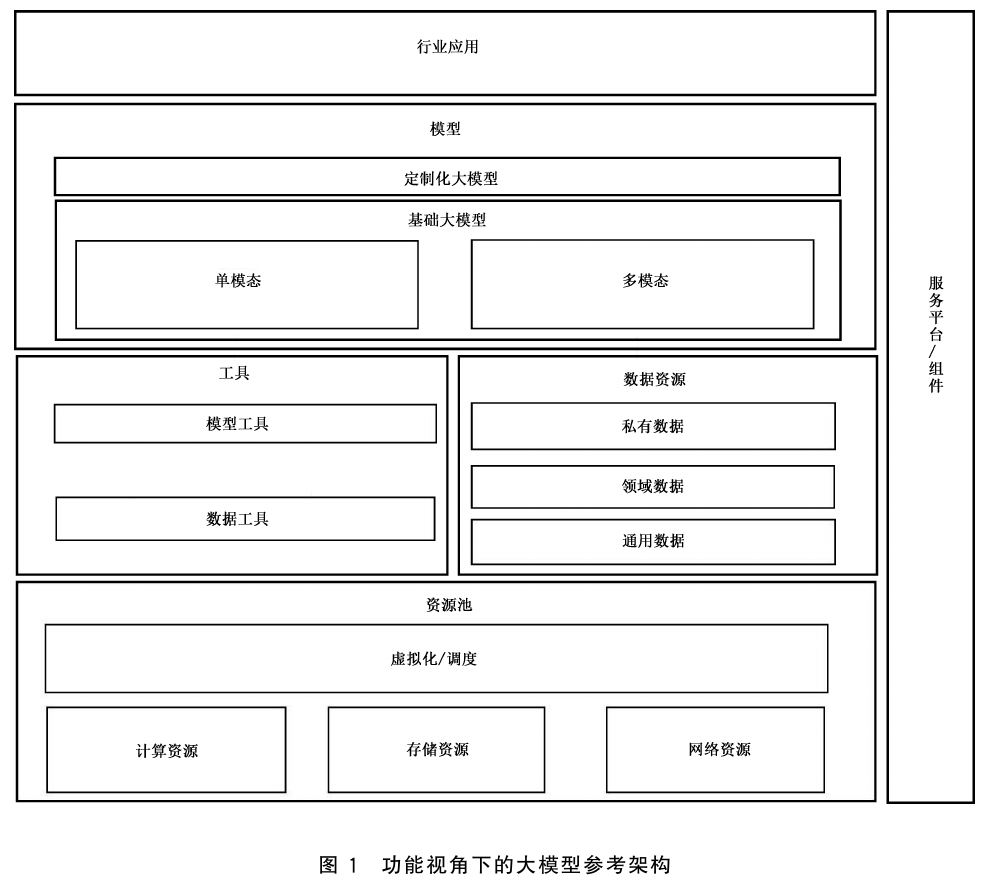
大模型 large-scale model 大规模深度学习模型 large-scale deep learning model 基于大量数据训练得到,具有复杂计算架构,能处理复杂任务,且具备一定泛化性的深度学习模型。 注:大模型的参数量由其功能和模态决定,一般不低于1亿。大模型训练使用的数据总量受参数量的影响,达到收敛的大模型的参数量的对数与其训练数据总量的对数成正比。
3.2
大模型服务 large-scale model service 开发、应用大模型及大模型系统的服务,以及以此为手段提供支持需求方业务活动的服务。 注:常见大模型服务内容包括大模型平台服务、大模型开发定制服务、大模型推理及运营服务。
为模型训练和推理提供计算和数据处理等能力的物理计算设施用器件[如中央处理器(CPU),图形处理器(GPU),现场可编程门阵列(FPGA),神经网络处理器(NPU),张量处理器(TPU)]或虚拟计算设备。 a) 应执行至少1种模态(如文本、图像、语音)的模型训练或推理。 b) 应具备人工智能计算的硬件加速功能,配备分布式训练和推理计算加速库: 1) 训练服务器:应具有不少于4个100GE网口;电源模块、风扇模块应具备热插拔和备份功能(如2+2冗余,N+1冗余等); 2) 推理服务器:内存总带宽应不小于800GB/s;应具有不少于2个高速串行计算机扩展总线标准(PCIe)扩展槽位;电源模块、风扇模块应具有热插拔和备份功能(如1+1冗余,N+1冗余等)。 c) 宜具备基于硬件加速的预处理功能(如图像、视频编解码)。 d) 应具备键值对缓存功能。
5.1.2 存储资源
适用于大模型训练和推理的存储资源,包含存储服务器等。存储资源用于提供数据存储和模型存储: a) 应具备数据集的分布式存储与访问功能,和冗余备份机制; b) 应具有标准文件系统接口,如可移植操作系统接口(POSIX); c) 存储带宽宜不小于200GB/s,输入/输出操作次数(IOPS)宜不小于200万次/秒; d) 宜具备内存计算功能; e) 宜以存储服务器或硬磁盘为单元创建存储池,存储池宜能识别、管理固态盘、硬磁盘等不同类型存储媒体。
5.1.3 网络资源
适用于大模型训练和推理的网络资源,包含集群内交换机和路由器: a) 应适配高速网络通信协议,如100GE,基于融合以太网的远程直接内存访问(RoCE)等; b) 转发包率宜不小于4000Mpps; c) 应具备负载均衡功能; d) 宜具备可靠性组网方案,如链路聚合、跨设备链路聚合组双活(M-LAG)等; e) 宜具有服务器集群内40GE、100GE、200GE或400GE的全连接网络; f) 宜具备物理交换机与逻辑交换机之间的映射功能,单台物理交换机故障不影响训练、推理任务执行。
5.1.4 虚拟化及调度
应符合GB/T42018—2022中6.2与GB/T45401.1—2025的规定。
5.2 工具
5.2.1 数据工具
5.2.1.1 数据采集工具
用于数据采集的数据工具功能包括: a) 应提供数据采集任务设定功能,包含采集需求、数量、数据源、所采集数据的类别(如文本、语音、图片和视频等)和范围(如话题、内容等); b) 应具备多种类型数据的采集功能,包括文本、视频、图像、音频等; c) 应具备采集数据来源、时间和采集方式的记录功能; d) 应具备结构化、半结构化、非结构化的数据接入功能; e) 宜具备数据质量检测和数据清洗功能。
5.2.1.2 数据准备工具
用于数据准备的数据工具功能包括: a) 数据标注流程应符合GB/T42755—2023中第6章和第7章的要求; b) 应具备数据清洗功能,包括文本数据的敏感词与特殊符号过滤、图像数据重建与去模糊、视频与音频数据的特定片段截取等; c) 应具备数据重组、数据标签格式转换功能; d) 应具备数据检索、分析等功能; e) 应具备数据增强及扩充功能(如添加扰动产生新数据); f) 应具备数据质量检测功能。
5.2.1.3 数据存储工具
用于数据存储的数据工具功能包括: a) 应具备分布式存储功能; b) 应具备在线弹性扩展功能; c) 应具备向量储存功能。
5.2.1.4 数据管理工具
用于数据管理的数据工具功能包括: a) 应具备数据集要素管理功能(数据集要素包括数据集名称、版本、标注类型、标注标签、数据量、数据来源、创建时间等); b) 应具备数据集操作功能,包括创建、查询、修改、删除、导入、导出、发布等; c) 应具备数据集状态信息查询功能,状态信息包括数据集名称、标注类型、数据量、导入状态、已标注状态和版本等。
5.2.2 模型工具
5.2.2.1 模型设计工具
模型设计工具: a) 应提供预定义的模型元素(如算子、模块等)和架构; b) 宜具备特定人工智能加速器上模型的训推模拟和性能分析。
5.2.2.2 模型训练工具
模型训练工具: a) 应具备分布式训练能力,适配数据并行、模型并行、混合并行等分布式训练方法; b) 训练集群在训练中出现节点故障(如宕机)时,应具有断点继续训练能力; c) 应具备基于训练数据的整体或部分特征,构建预训练任务的功能; d) 应具备模型历史版本和微调迭代过程的日志及查询功能,包含准确率、损失、参数更新等信息; e) 宜提供多种并行策略,包括算子切分、算子自动并行等,宜支持自定义算子。
5.2.2.3 模型优化工具
模型优化工具符合以下规定。 a) 应具备模型压缩功能(如剪枝、量化、知识蒸馏等),宜适配组合策略压缩方案。 b) 模型微调: 1) 应具备基于文本、语音、图像或视频等数据的微调能力; 2) 应具备单模态、多模态大模型的微调能力; 3) 应具有模型评估指标体系,如准确率等; 4) 宜具备基于用户反馈的微调功能(如基于用户反馈的强化学习)。 c) 宜具备混合精度训练(自动精度混合、手动精度混合)、参数分片、梯度分片等优化训练方法(使用的精度如半精度浮点,四分之一精度整型或单精度浮点等)。
5.2.2.4 模型验证工具
模型验证工具: a) 应具备大模型功能(如自然语言处理、计算机视觉、多模态等)效果评估能力; b) 应提供自动化测试功能; c) 应具备自定义测试指标功能; d) 宜具备模型性能实时监测和日志记录功能。
5.2.2.5 模型部署与推理工具
模型部署与推理工具: a) 应提供服务器本地部署、云上部署功能,宜提供边缘侧(如边缘服务器)和端侧(如移动通信终端)的模型部署功能; b) 应提供低时延推理实现机制; c) 应具备模型推理过程的监控和日志记录功能; d) 宜提供工具链,实现基于自然语言处理模型、视觉模型、多模态模型、科学计算模型等模型的下游任务构建; e) 宜具备检索增强生成功能。
单模态大模型或系统: a) 应提供单模态数据的特征提取; b) 应具备至少1种单模态理解能力,单模态理解能力见GB/T45288.2中给出的理解能力维度; c) 宜具备至少1种单模态生成能力,单模态生成能力见GB/T45288.2中给出的生成能力维度。
5.4.1.2 多模态
多模态大模型或系统,符合以下要求: a) 应具备至少1种多模态理解能力,多模态理解能力见GB/T45288.2中给出的理解能力维度; b) 应具备至少1种多模态生成能力,多模态生成能力见GB/T45288.2中给出的生成能力维度。
5.4.2 定制化大模型
基于大模型,定制应用环境所需的模型及系统: a) 应具有至少2种微调方法,如提示词微调、全参微调、参数高效微调等; b) 应提供并运营大模型库,实现用户上传、微调和使用模型。
5.5 行业应用
对每种大模型(自然语言处理,计算机视觉,多模态等),宜至少匹配2个下游任务。
5.6 服务平台/组件
大模型服务平台/组件,宜。 a) 具备大模型插件开发能力,提供开发协议以规定插件的规则和接口,如模型接口、输入输出数据格式、插件元数据和插件运行状态码等。 b) 具备部署服务升级、回滚能力。 c) 具备计算资源弹性伸缩能力。 d) 具备大模型灰度发布(逐步将新功能或修改过的版本推向部分用户,以测试和验证其在更大范围内的表现的软件或产品更新方法)和A/B测试(通过为用户随机提供在单个变量上有所不同的产品或服务,收集并分析对应行为数据,验证不同版本之间的差异是否具有统计学意义。 测试中将一个总体样本随机分成A组和B组两组,分别给予不同的处理或方案,通过对比两组结果,确定哪种处理或方案更优)功能。 e) 大模型组件具备自动检测和修复能力。 f) 具备插件运行监控和日志记录功能。